

Tests et comparatifs
Tests détaillés et comparatifs de matériel grand public.
2 projets trouvés
Filtres 1
Matériel
Skills
Terminé ⚔️ Comparatif
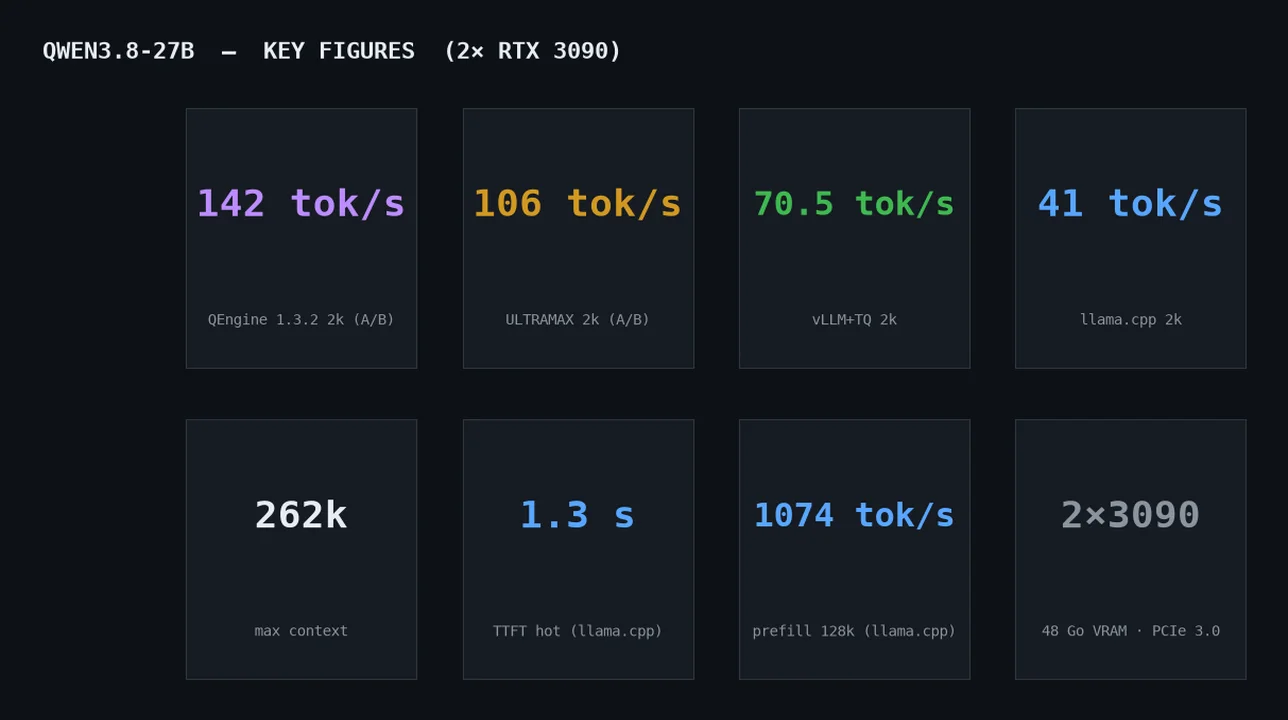
Qwen 3.8 27B sur 2 RTX 3090 + 128GB de RAM : QEngine, ULTRAMAX, vLLM ou llama.cpp ?
J'ai comparé 4 moteurs pour Qwen 3.8 27B, la version dense du modèle, sur ma machine : 2 RTX 3090 de 24 Go, 128 Go de RAM et un PCIe 3.0. Tout vient de mon banc, avec les mêmes prompts. Deux réserves, que je rappelle à chaque fois : les chiffres ne viennent pas tous de la même session, et la comparaison n'est pas à quantification égale.
Inférence LLM locale Linux Benchmarking
+5
- en
- fr
 fabz 🧪 🧠 🌱 🏅 32
Terminé ⚔️ Comparatif
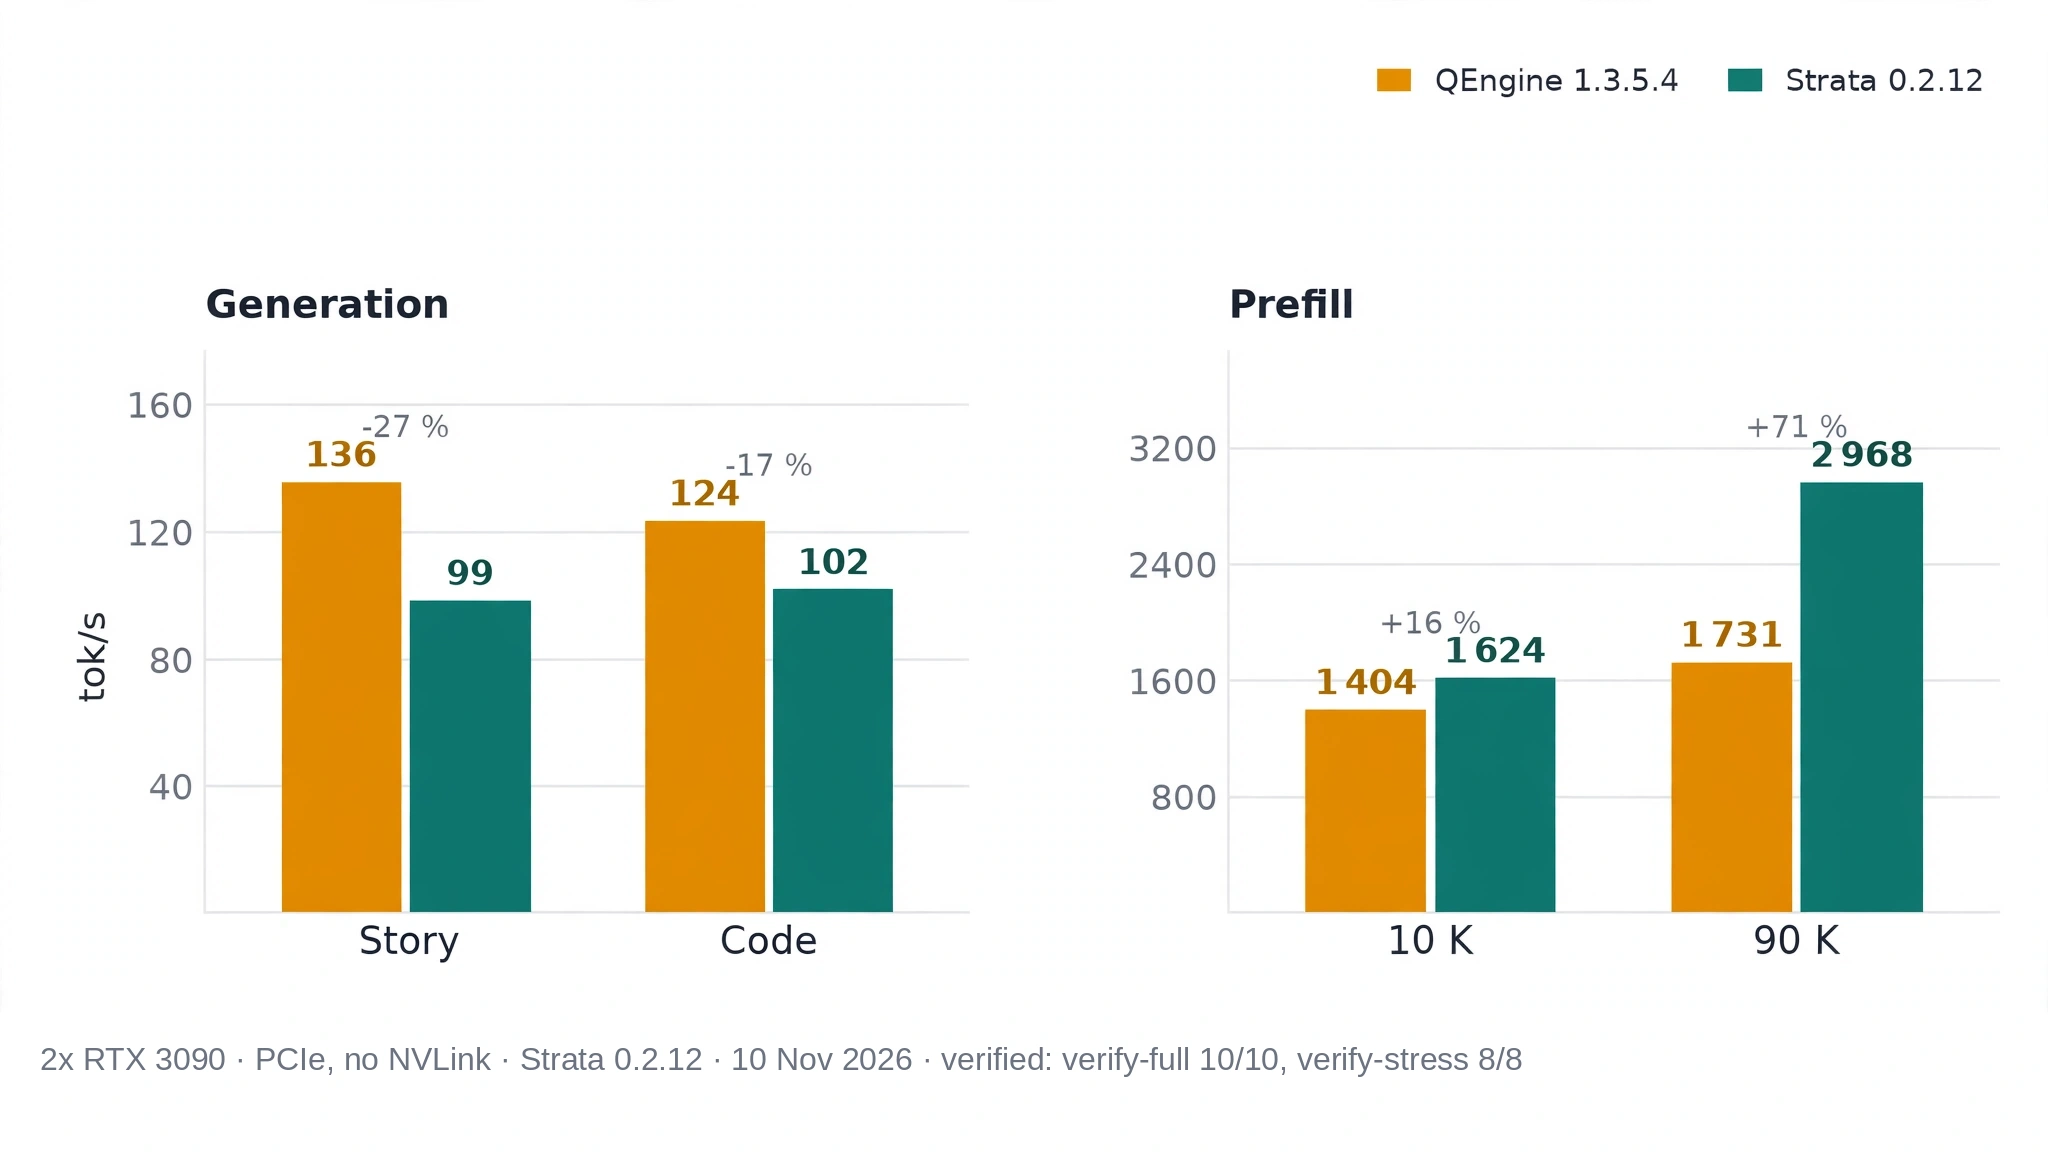
Qwen 3.8 Flash Next sur 2 RTX 3090 + 128Go de RAM : QEngine, Strata, vLLM ou llama.cpp ?
J'ai hésité entre ces 4 moteurs pour faire tourner Qwen 3.8 Flash Next (QFN) sur ma machine : 2 RTX 3090 de 24 Go, 128 Go de RAM et un PCIe 3.0. J'ai mesuré moi-même QEngine et Strata. Pour vLLM et llama.cpp, je m'appuie sur les chiffres publiés par d'autres sur des rigs 2×3090.
Inférence LLM locale Linux Configuration GPU / CUDA
+7
- en
- fr
fabz 🧪 🧠 🌱 🏅 51 