

Hardware · Domotique · Reverse Engineering · IA locale
Maîtrisez votre hardware
On démonte, on mesure, on documente, on publie. Projets hardware / software grand public, reverse engineering, domotique Home Assistant, IA locale et inférence maison.
Système d'irrigation Zigbee sous Home Assistant — 3 zones, 100% local
Automatisez l'arrosage de vos plantes avec un commutateur Zigbee 4 canaux, des pompes DC, des capteurs d'humidité Tuya et Home Assistant. Gestion multi-zones, seuils configurables, mode automatique et supervision complète.
 fabz 🧪 🧠 🌱 🏅 95
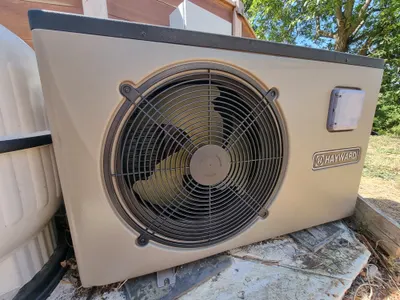
Piloter une PAC Hayward en wifi avec un ESP32-S3 sous Home Assistant
Comment connecter une pompe à chaleur Hayward de piscine à Home Assistant via un ESP32-S3 Zero, un module RS485 et ESPHome. Guide complet : hardware, soudure, sniffing Modbus, YAML et intégration Lovelace.
fabz 🧪 🧠 🌱 🏅 95 
Fabriquer un capteur de CO2 Zigbee avec ESP32-H2 et MH-Z19 pour Home Assistant
Guide complet pour construire un capteur de CO2 Zigbee avec un ESP32-H2 Super Mini, un capteur MH-Z19 et une LED RGB. Firmware Arduino, intégration Zigbee2MQTT et carte Lovelace pour Home Assistant.
fabz 🧪 🧠 🌱 🏅 2 96 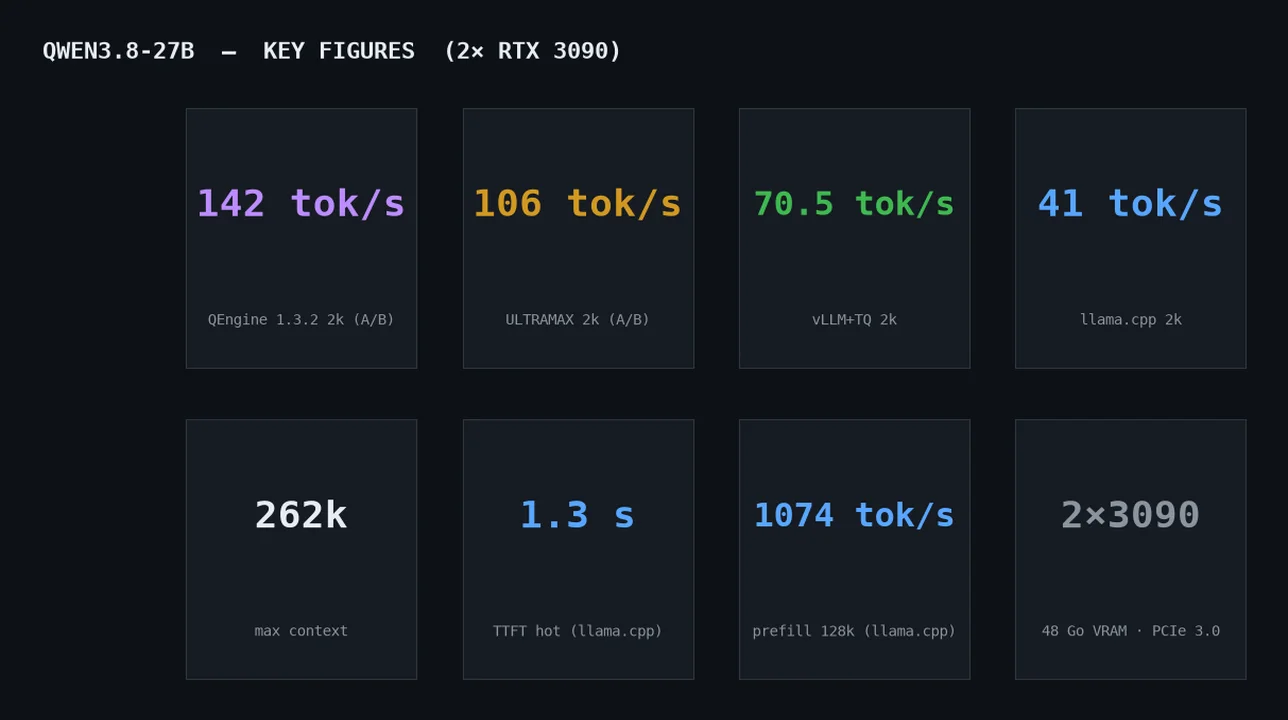
Qwen 3.8 27B sur 2 RTX 3090 + 128GB de RAM : QEngine, ULTRAMAX, vLLM ou llama.cpp ?
J'ai comparé 4 moteurs pour Qwen 3.8 27B, la version dense du modèle, sur ma machine : 2 RTX 3090 de 24 Go, 128 Go de RAM et un PCIe 3.0. Tout vient de mon banc, avec les mêmes prompts. Deux réserves, que je rappelle à chaque fois : les chiffres ne viennent pas tous de la même session, et la comparaison n'est pas à quantification égale.
- en
- fr
fabz 🧪 🧠 🌱 🏅 32 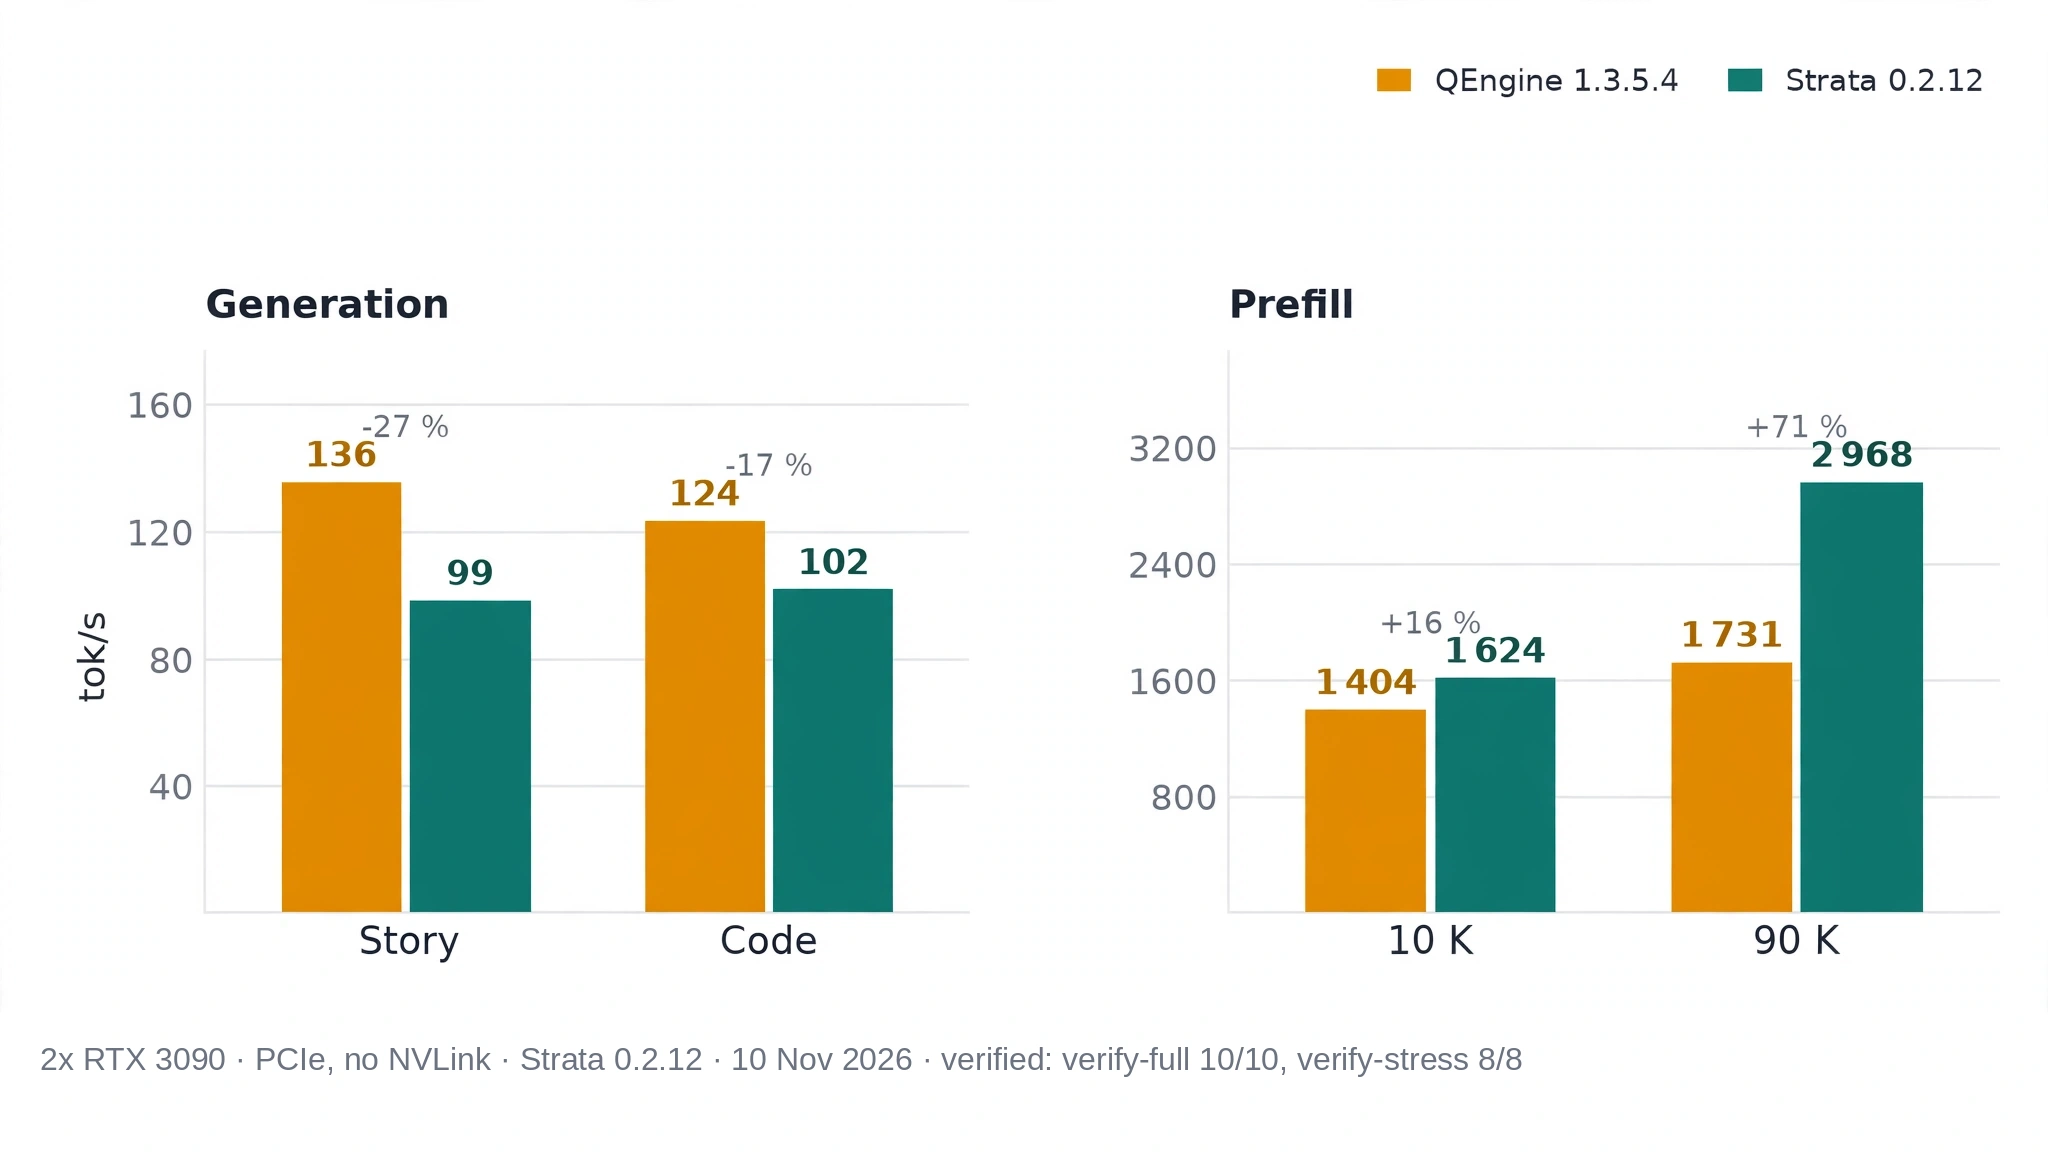
Qwen 3.8 Flash Next sur 2 RTX 3090 + 128Go de RAM : QEngine, Strata, vLLM ou llama.cpp ?
J'ai hésité entre ces 4 moteurs pour faire tourner Qwen 3.8 Flash Next (QFN) sur ma machine : 2 RTX 3090 de 24 Go, 128 Go de RAM et un PCIe 3.0. J'ai mesuré moi-même QEngine et Strata. Pour vLLM et llama.cpp, je m'appuie sur les chiffres publiés par d'autres sur des rigs 2×3090.
- en
- fr
fabz 🧪 🧠 🌱 🏅 51 