

Qwen 3.8 Flash Next sur 2 RTX 3090 + 128Go de RAM : QEngine, Strata, vLLM ou llama.cpp ?
QEngine is the best overall choice based on our tests.
QEngine 1.3.5
- ✓ **MESURÉ**
- ✓ 96 GB de RAM
- ✓ Contexte max 262K
- ✓ Démarrage à froid 5 min
- ✓ Préfill 10K / 90K (tok/s) : 1 400 / 1 730
- ✓ Décodage narration / code (tok/s) : **136 / 124**
- ✓ Licence PolyForm Noncommercial
Strata 0.2.12
- ✓ **MESURÉ**
- ✓ 64 GB de RAM
- ✓ Contexte max 262K
- ✓ Démarrage à froid 7 min
- ✓ Préfill 10K / 90K (tok/s) : **1 620 / 2 970**
- ✓ Décodage narration / code (tok/s) : 99 / 102
- ✓ Licence **MIT**
vLLM (recipe bucko)
- ✓ **NON MESURÉ**
- ✓ 128 GB de RAM + swap
- ✓ Contexte max 262K
- ✓ Démarrage à froid 9 min
- ✓ Préfill 10K / 90K (tok/s) : 1 400-1 860
- ✓ Décodage narration / code (tok/s) : 80-89
- ✓ Licence Apache-2.0
llama.cpp
- ✓ **NON MESURÉ**
- ✓ 110 GB de RAM
- ✓ Contexte max 262K
- ✓ Démarrage à froid 10 min
- ✓ Préfill 16K (tok/s) : 725-890
- ✓ Décodage narration / code (tok/s) : 37-49
- ✓ Licence **MIT**
Also available inEnglishFrench(original)
En 30 secondes
| Tu veux… | Prends… | Pourquoi | À savoir |
|---|---|---|---|
| Générer vite, lancer plusieurs agents en parallèle | QEngine | le plus rapide en décodage, 8 requêtes simultanées | licence non commerciale, ~96 Go de RAM |
| Relire de gros contextes, ménager la RAM, ou publier un service | Strata | préfill à 90K plus rapide, 31 Go de RAM en moins, licence MIT | une seule requête à la fois |
| Du validé et stable, quitte à attendre | vLLM (recette Bucko) | testé en conditions réelles, Apache-2.0 | environ 2× plus lent, démarrage vers 9 min |
| Rester simple, ou n'avoir qu'un seul GPU | llama.cpp | supporté en amont, tourne partout | 3 à 4× plus lent |
Chez moi, QEngine reste le moteur par défaut, et Strata est installé à côté pour les gros contextes.
Pourquoi ce modèle change la comparaison
QFN n'est pas un modèle dense qu'on quantifie et qu'on case dans la carte. C'est un MoE d'environ 125 milliards de paramètres (512 experts, 10 activés par token, soit ~6 milliards actifs), auquel s'ajoute une table n-gram de 51,2 milliards : 176 milliards au total. Ça ne rentre pas dans mes 48 Go de VRAM. Une partie des experts et la table vivent donc dans la RAM de la machine, et les moteurs se différencient sur la façon dont ils les font circuler.
Si tu montes une machine pour ce modèle, la RAM et la génération du PCIe pèsent plus lourd que le modèle exact de la carte. La VRAM par carte reste la condition d'entrée, pas le facteur qui fait la différence.
Quelques mots à connaître pour la suite :
- tok/s : tokens générés par seconde (le décodage). Une lecture humaine tourne autour de 6 tok/s : la différence ne se sent vraiment que sur les longues générations et les agents.
- Préfill : la vitesse à laquelle le moteur lit ton prompt. C'est elle qui décide de l'attente avant le premier mot sur un gros contexte.
- TTFT : le temps avant le premier token de réponse.
- Drafter / MTP : un petit modèle propose plusieurs tokens d'avance, le gros les valide. Ça accélère le décodage.
- P2P : transfert direct d'une carte à l'autre, sans passer par la RAM. Mes cartes n'en ont pas, ça compte plus loin.
Ma machine
2 RTX 3090 de 24 Go (dont une Ti), un AMD EPYC 7401P de 24 cœurs, 125 Go de DDR4, PCIe 3.0 sur les deux cartes, et pas de P2P entre elles : le pilote le refuse.
Les chiffres publiés les plus flatteurs viennent de rigs en PCIe 4 avec P2P actif. Sans P2P, toutes les communications entre cartes passent par la mémoire de la machine, ce qui coûte cher à un MoE qui sollicite des milliers d'experts par pas. C'est pour ça que mes chiffres sont plus bas que ceux des fiches : QEngine annonce 165 tok/s en narration sur 2×3090 avec P2P, j'en mesure 136.
Les 4 moteurs en un tableau
| QEngine 1.3.5 | Strata 0.2.12 | vLLM (recette Bucko) | llama.cpp | |
|---|---|---|---|---|
| Chiffres | mesurés chez moi | mesurés chez moi | publiés, autres 2×3090 | publiés, autres 2×3090 |
| Décodage narration / code (tok/s) | 136 / 124 | 99 / 102 | 80-89 | 37-49 |
| Préfill 10K / 90K (tok/s) | 1 400 / 1 730 | 1 620 / 2 970 | 1 400-1 860 / non mesuré | 725-890 à 16K |
| Contexte max | 262K | 262K | 262K | 261K |
| RAM hôte | ~96 Go | ~64 Go | 100 Go et plus, + swap | ~110 Go |
| Démarrage à froid | 5 min | 7 min (installation comprise) | ~9 min | plusieurs minutes |
| Licence | PolyForm Noncommercial | MIT | Apache-2.0 | MIT |
Les moteurs les plus rapides du moment (capy-flash, Basalt, Infernix) visent les RTX 50 et le NVFP4, qu'une 3090 ne décode pas : ils sont hors jeu sur Ampère.
QEngine contre Strata : même modèle, même machine, mêmes scripts
Avant de parler vitesse, les deux ont passé les mêmes tests fonctionnels : tool calling, streaming (y compris les appels d'outils en streaming), mode reasoning, vision 4/4, et un contexte rempli jusqu'à 240K tokens (91 % des 262 144), avec l'aiguille retrouvée à chaque palier. Les poids sont proches en fidélité : environ 89 % d'accord avec le modèle non quantifié d'après les fiches (référence BF16 d'un côté, Q8_0 de l'autre). Rien dans mes tests n'indique un écart de qualité : c'est un arbitrage de vitesse et de mémoire.
| QEngine | Strata | Écart | |
|---|---|---|---|
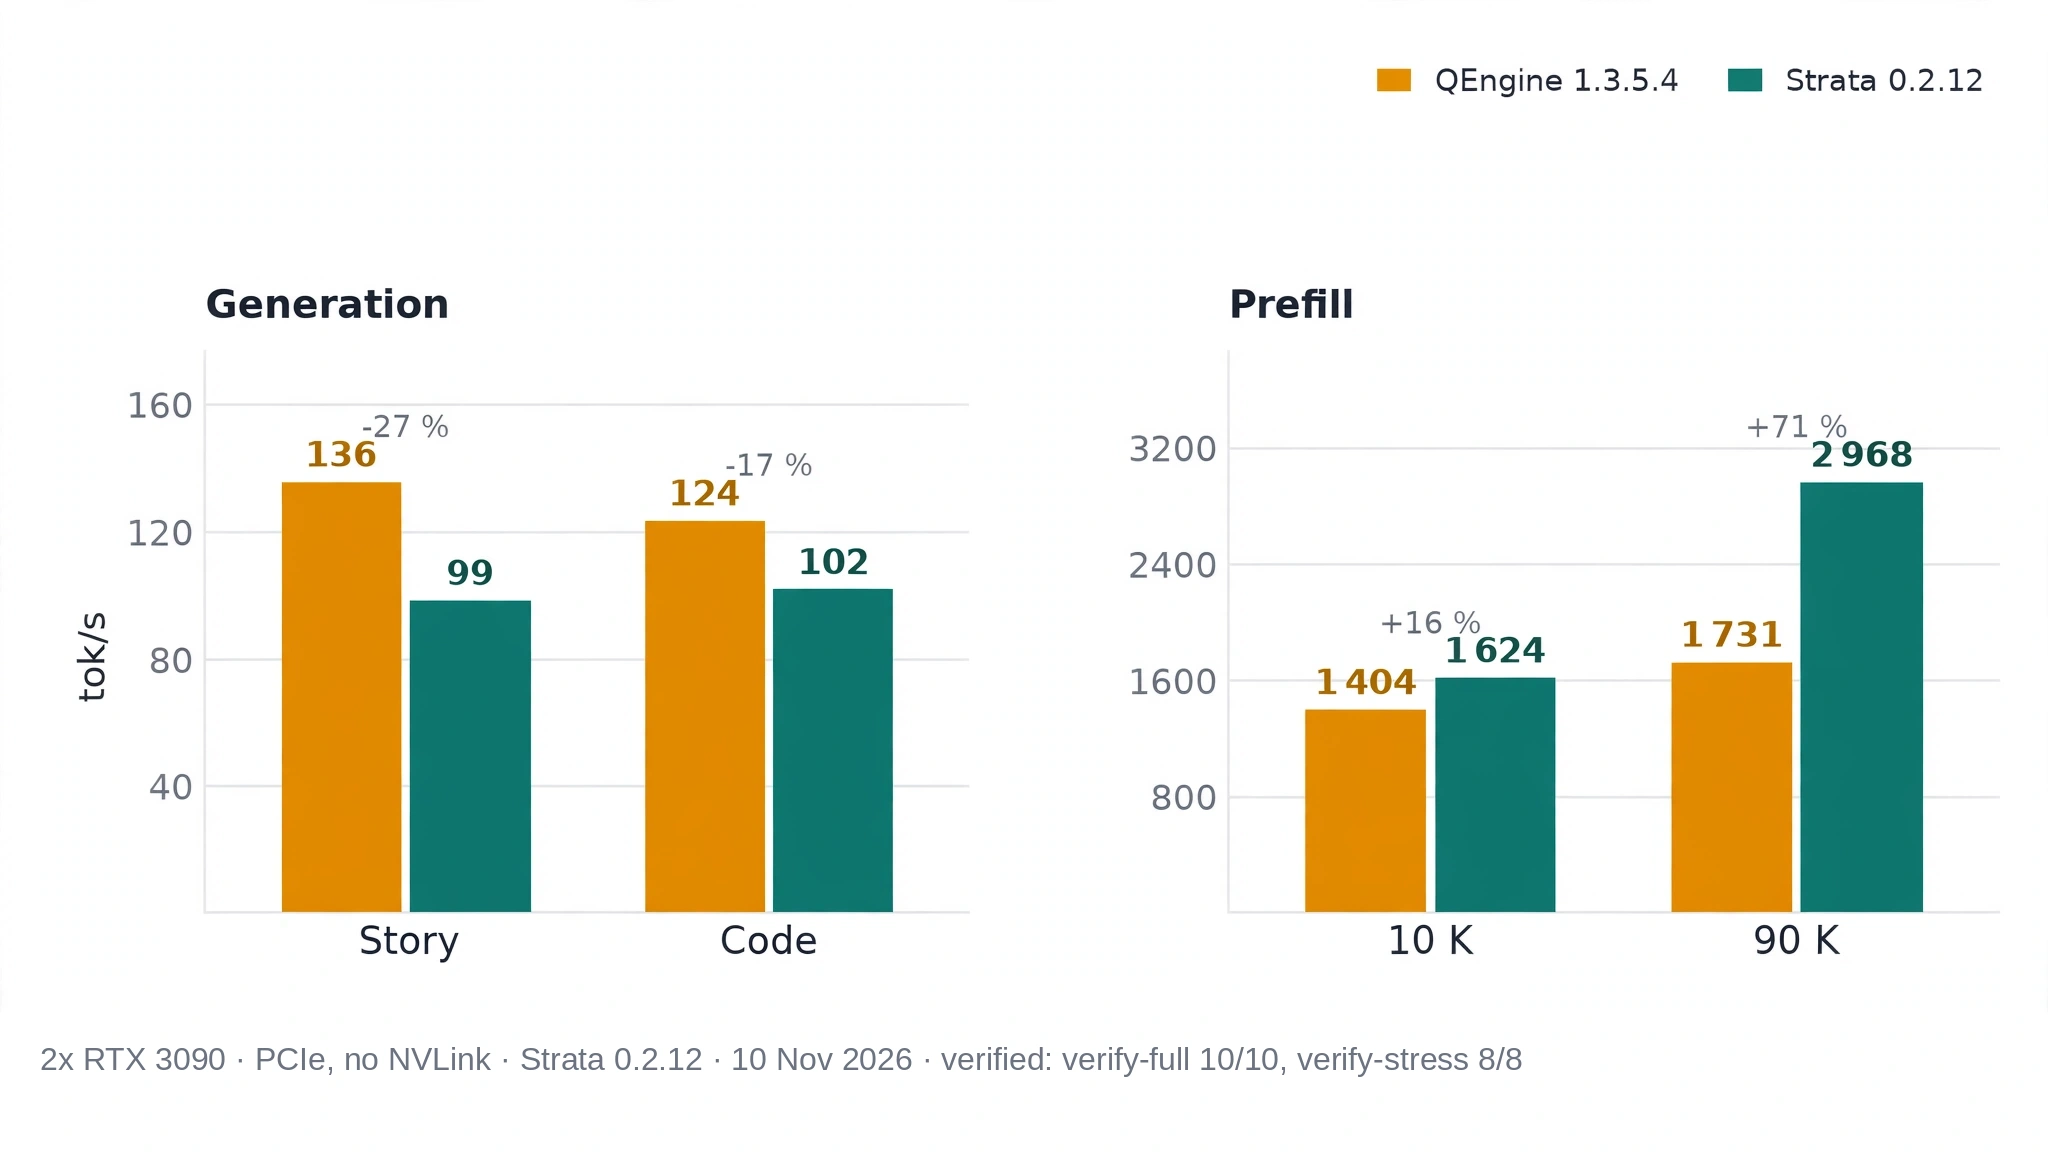
| Décodage narration (tok/s) | 136 | 99 | −27 % |
| Décodage code (tok/s) | 124 | 102 | −17 % |
| Préfill à 10K (tok/s) | 1 400 | 1 620 | +16 % |
| Préfill à 90K (tok/s, une mesure par moteur) | 1 730 | 2 970 | +71 % |
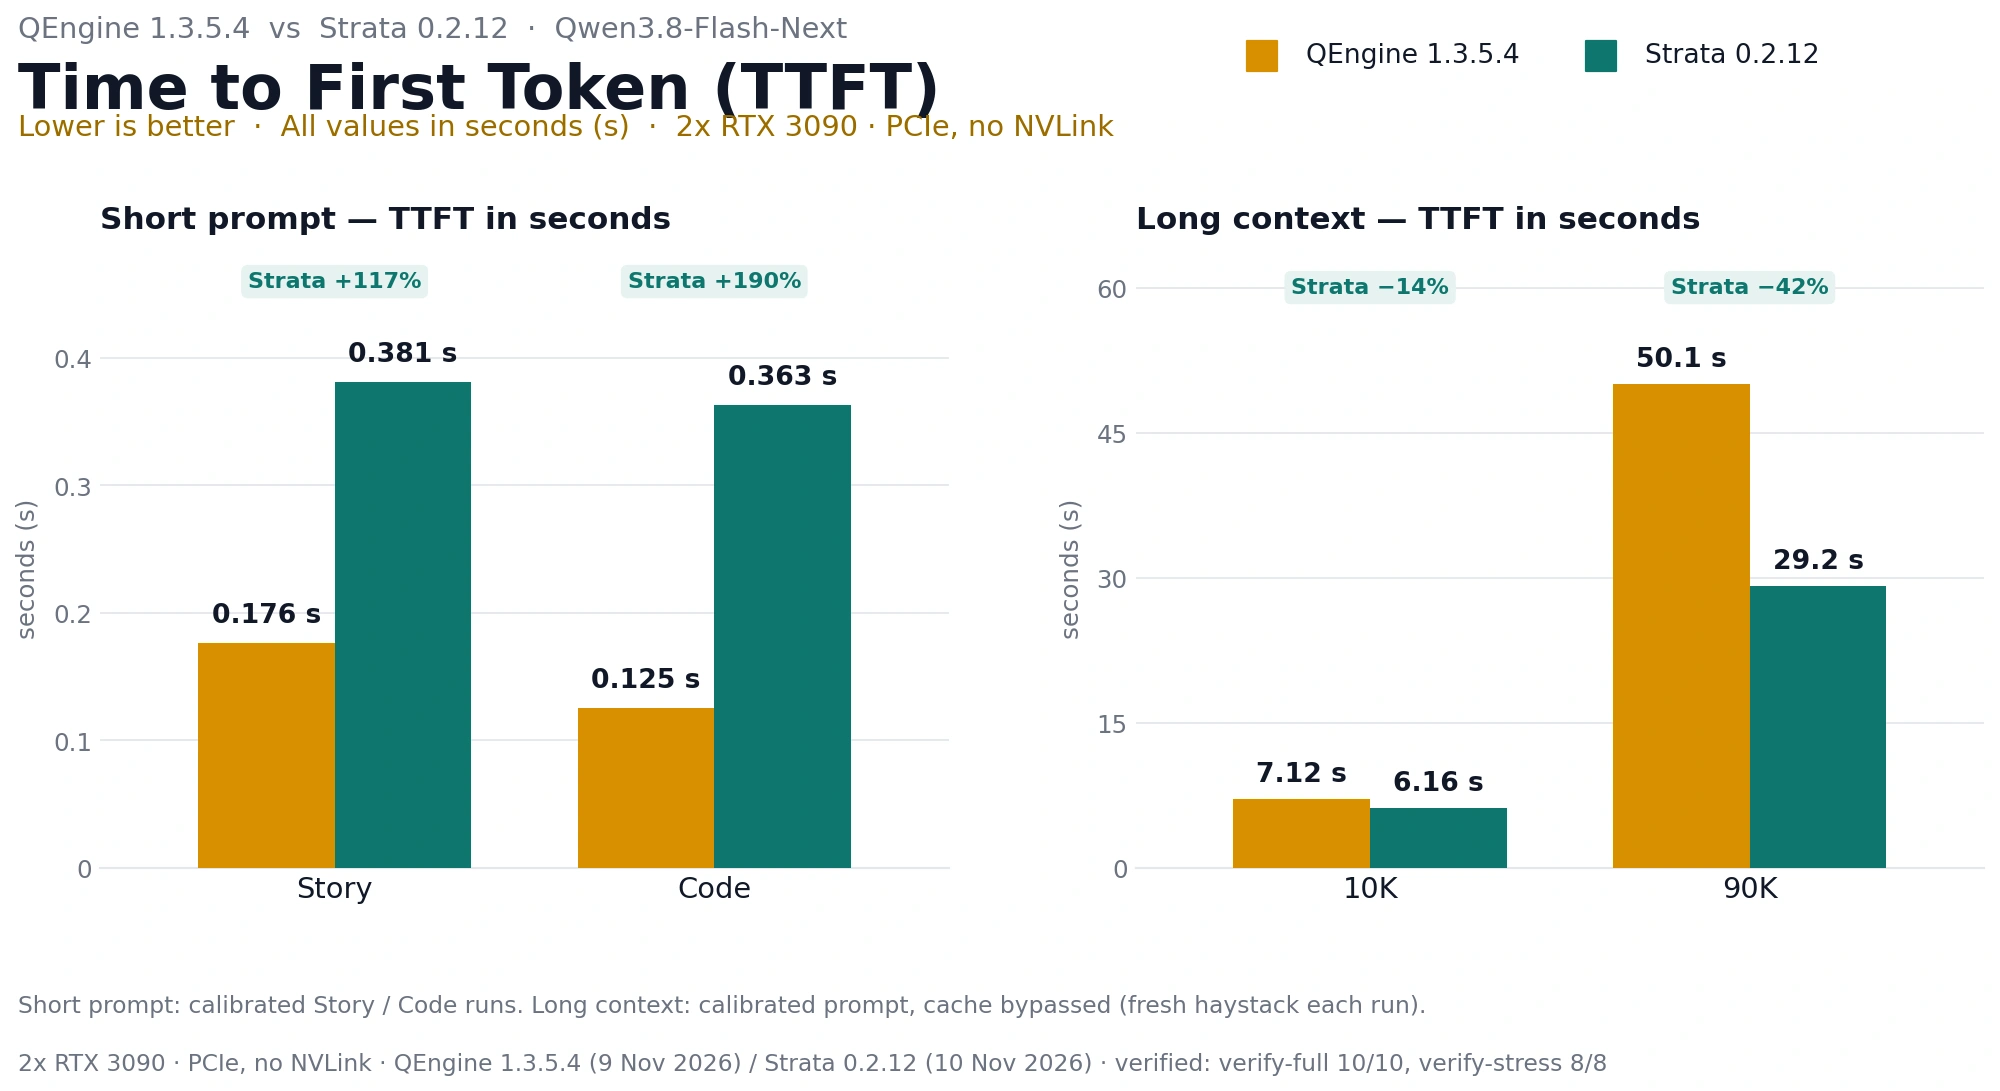
| Attente avant la 1re réponse à 90K | 50 s | 29 s | −21 s |
| RAM utilisée par le serveur | 96 Go | 64 Go | −31 Go |
| Requêtes en parallèle | 8 | 1 |
Écarts exprimés du point de vue de Strata. QEngine est ici dans la configuration Docker par défaut : son préfill gagne environ 17 % en corrigeant le placement mémoire, ce qui ramène les deux moteurs au même niveau à 10K (j'explique comment dans l'article suivant).
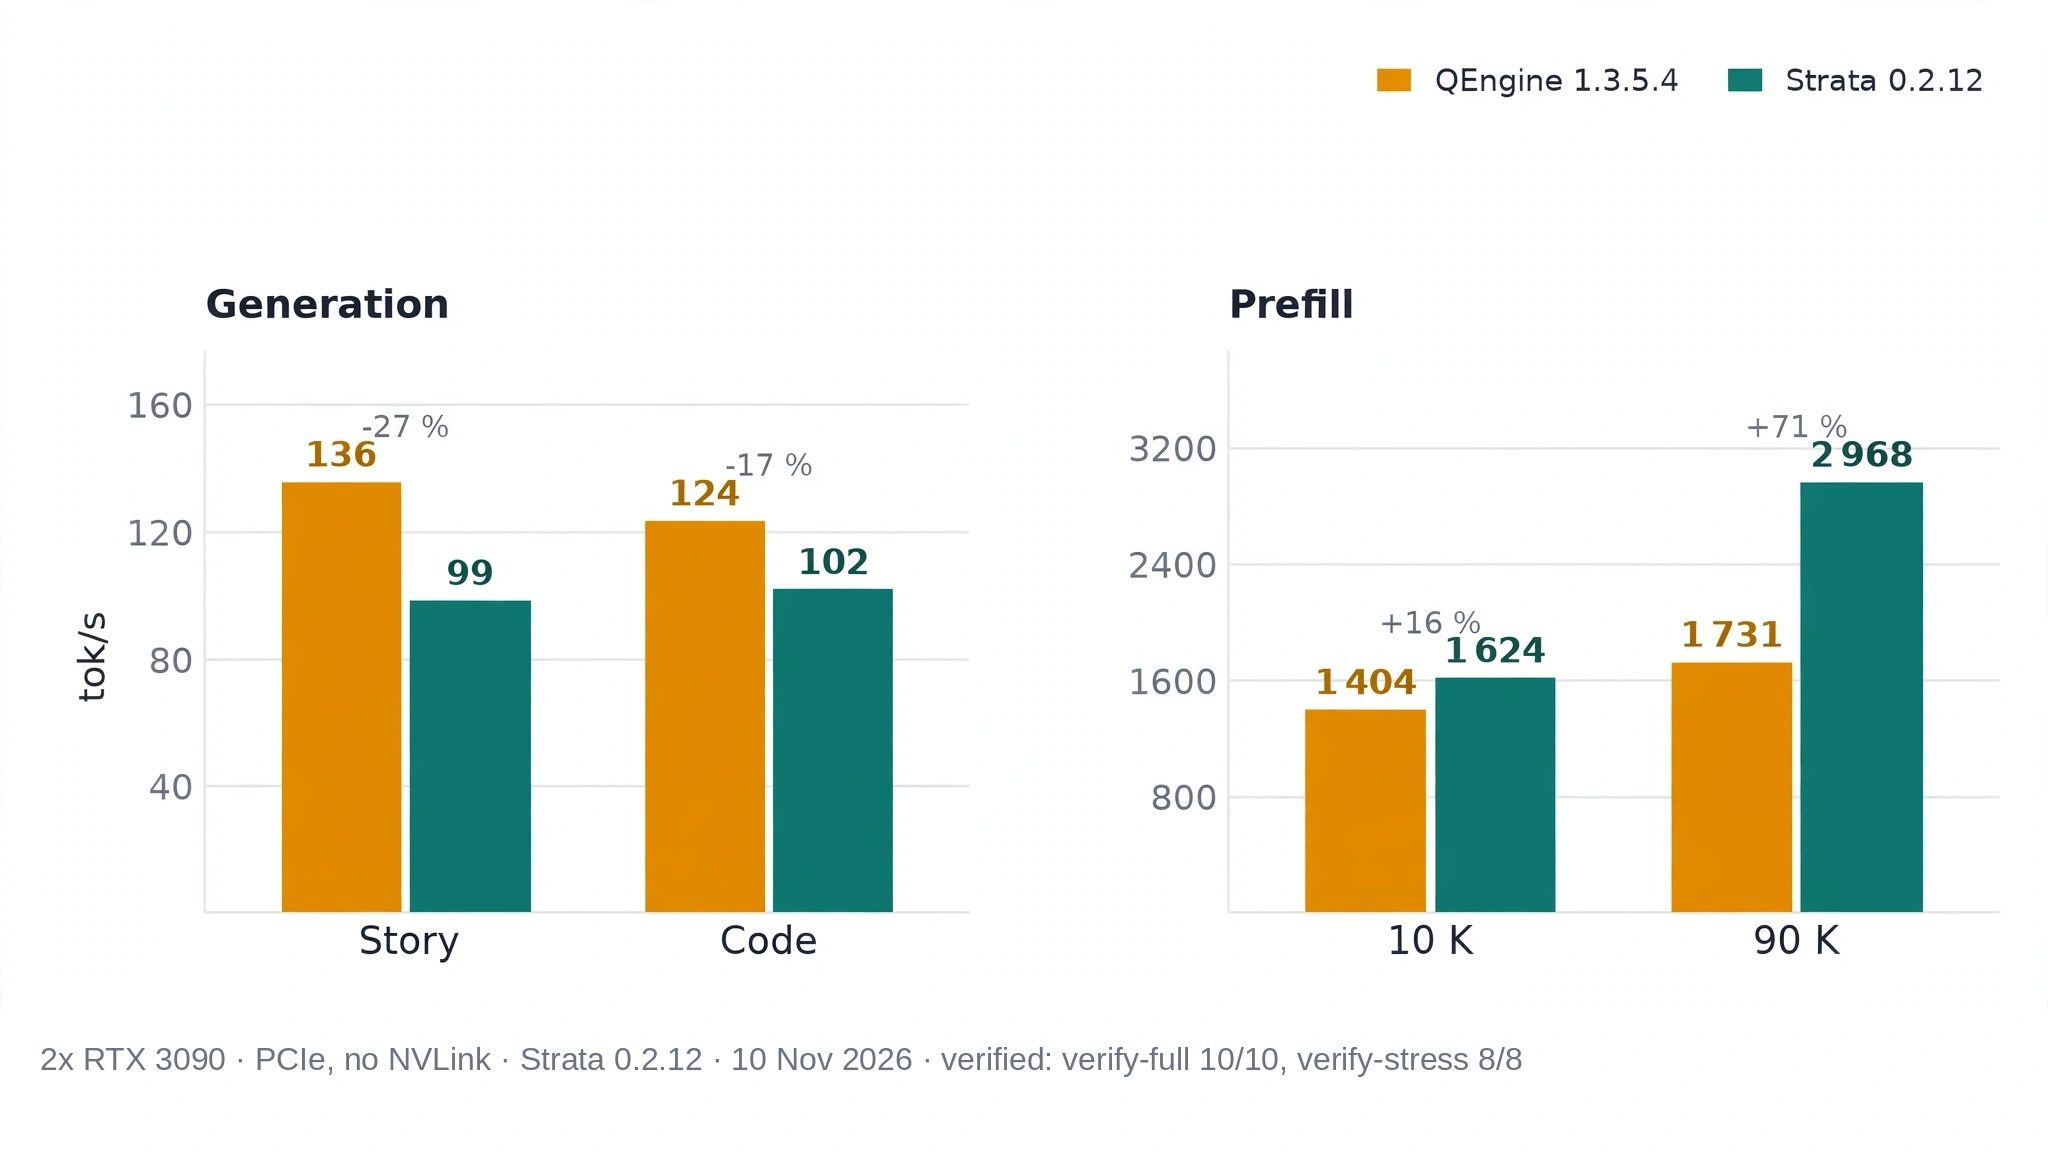
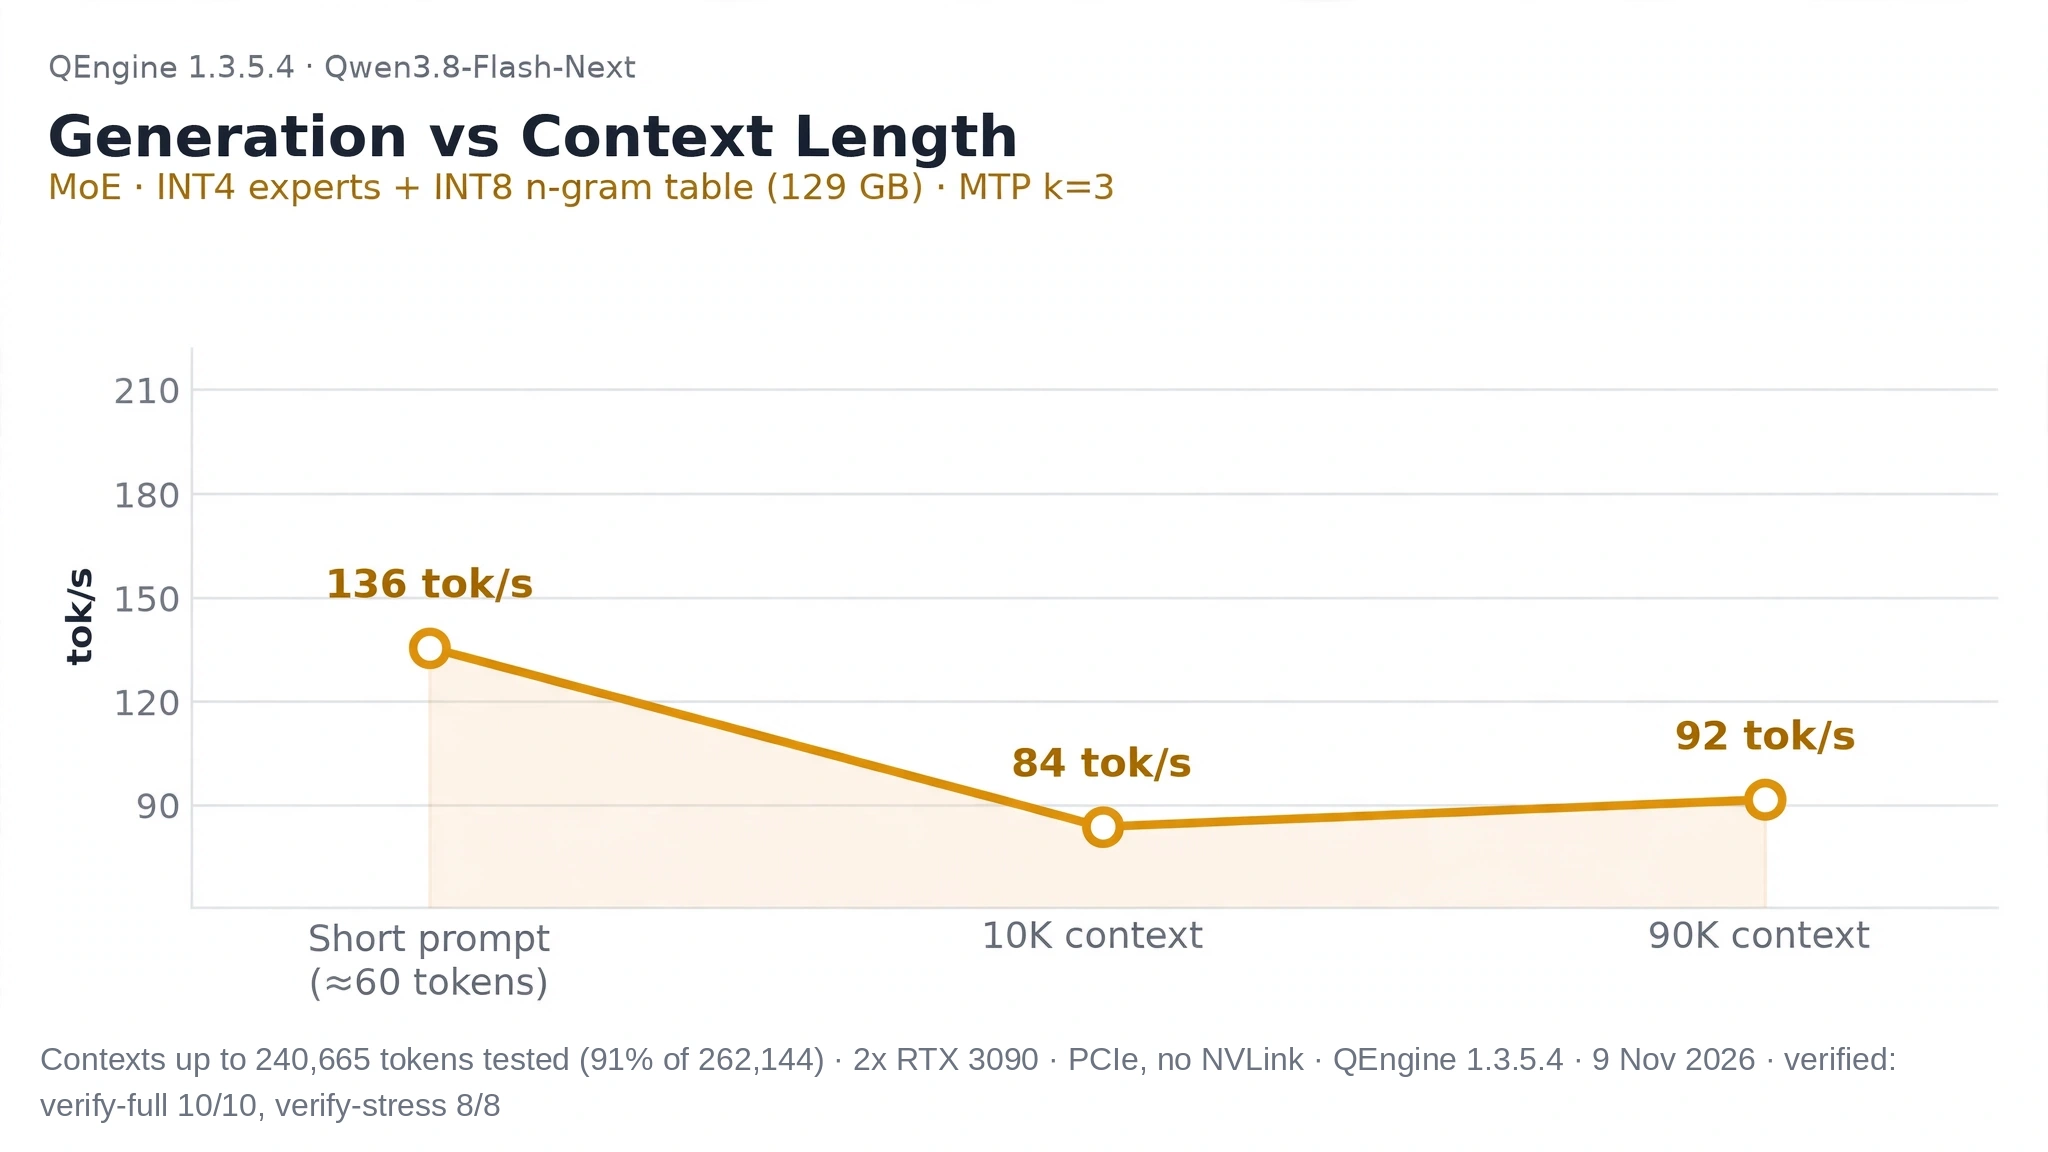
Le décodage. QEngine gagne sur prompt court (+38 %) et à 87K (92 contre 79 tok/s), mais les deux sont à égalité à 10K (84 contre 85). En usage réel, à 80-100K tokens de contexte, j'observe 78 à 127 tok/s sous QEngine, avec 99 % du cache réutilisé.
Le contexte long. Strata gagne, et pas seulement à 90K. Sur l'échelle de 94K à 240K, il tient autour de 3 100 tok/s de préfill à chaque palier, là où QEngine oscille entre 1 600 et 2 500. À 240K, il ne reste que ~120 MiB de VRAM libre par carte sous QEngine, contre 434 Mo constants sous Strata. C'est le régime où QEngine documente un graph instantiate out of memory.
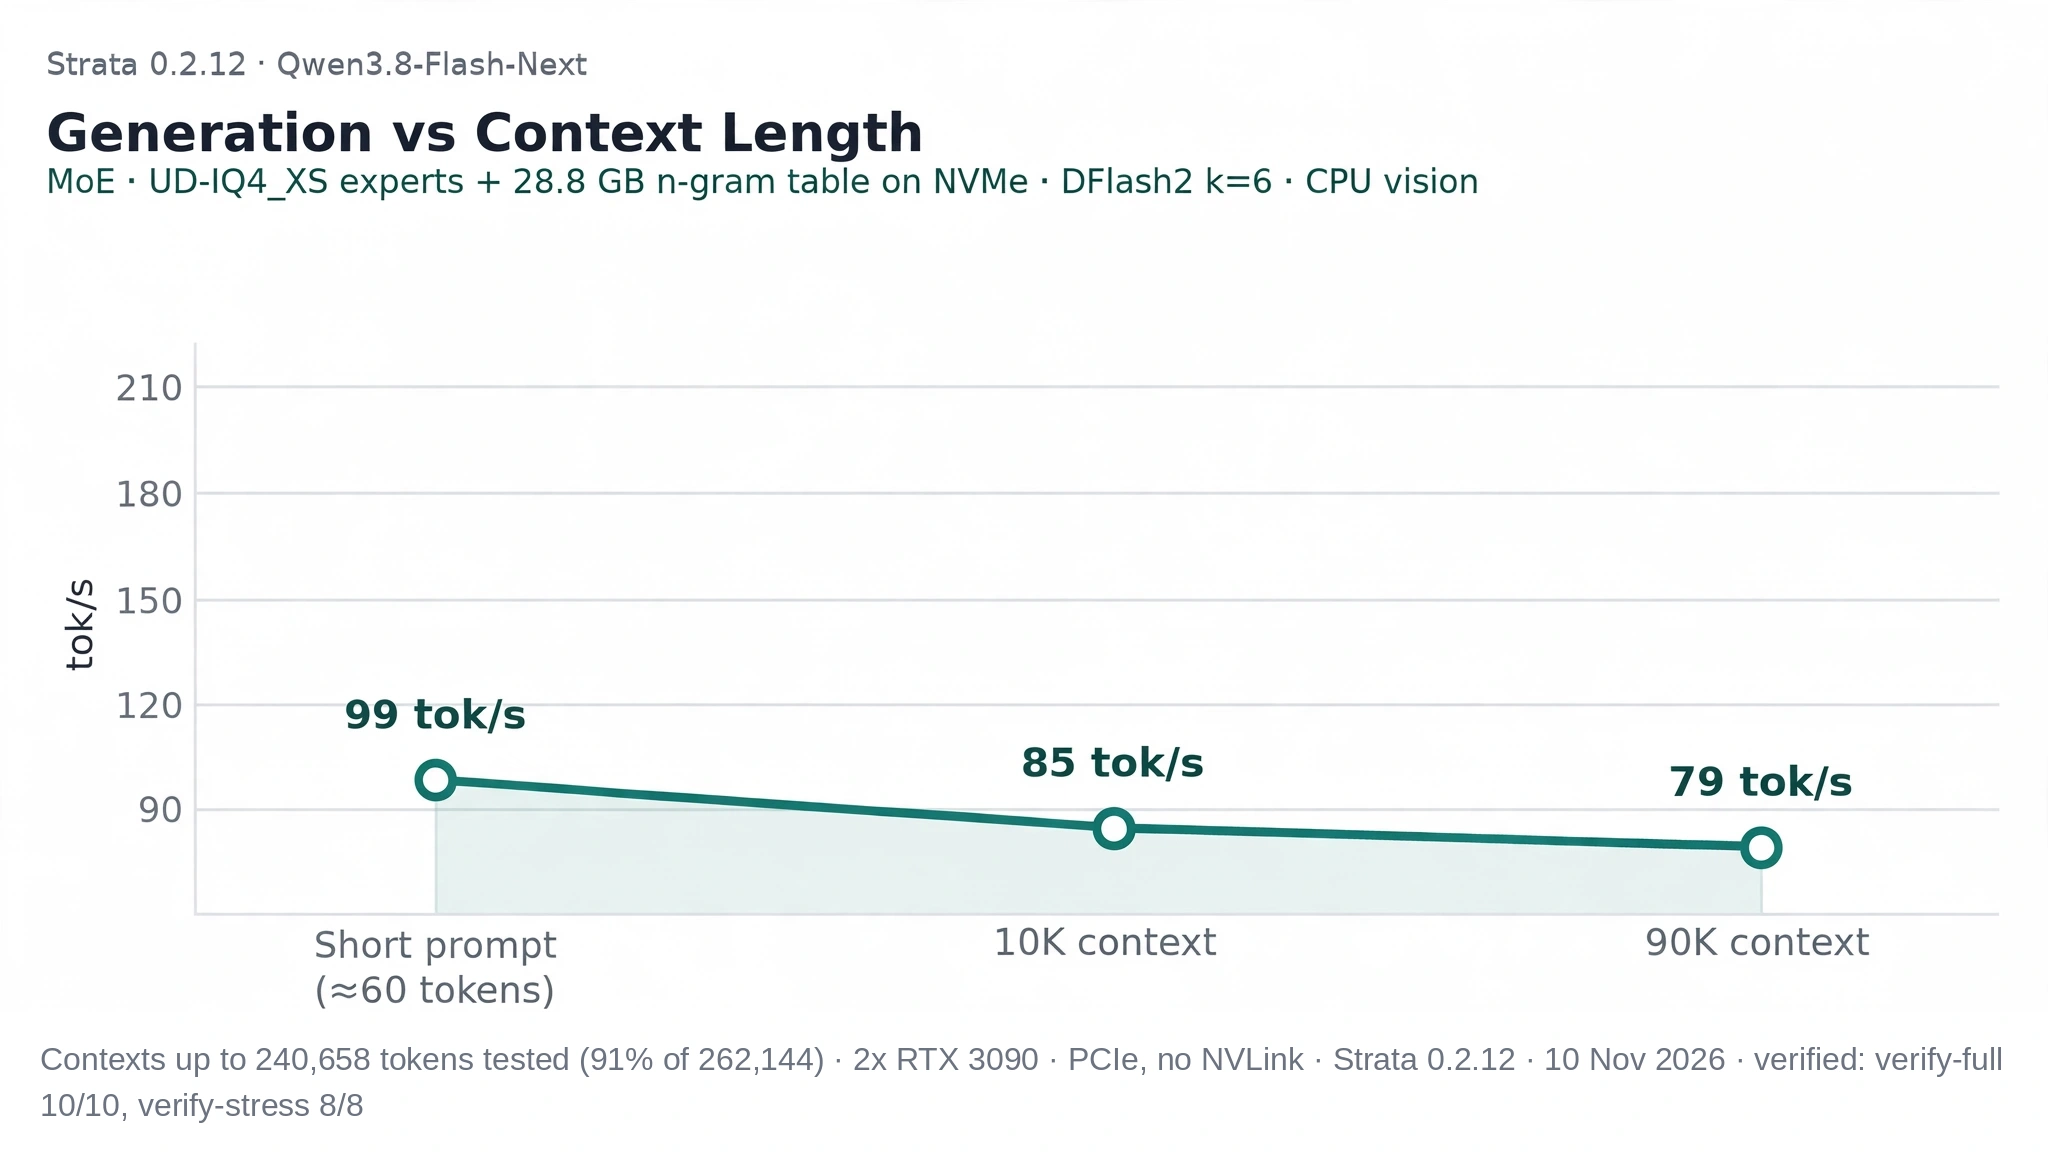
La RAM et la concurrence. Strata lit sa table n-gram (28,8 Go) directement sur le NVMe au lieu de l'épingler en RAM (51,8 Go chez QEngine) : 31 Go de RAM en plus de disponibles. Le prix : une seule requête à la fois, parce que son drafter ne répond qu'à une requête. Un agent qui lance des sous-agents en parallèle fait la queue, là où QEngine en sert 8. Ce n'est pas un réglage, c'est structurel.
La licence. QEngine est sous PolyForm Noncommercial 1.0.0 : à regarder de près si ton service dépasse le cadre personnel. Strata est en MIT.
En une phrase : l'un génère le texte bien plus vite (136 tok/s contre 99 en narration), l'autre avale un contexte de 90K bien plus vite (29 s d'attente contre 50 s). Le bon choix dépend donc de ce que tu fais du modèle, pas seulement de sa vitesse affichée.
Les 2 autres, en bref
vLLM. La recette de DominikBucko (vLLM épinglé et patché, checkpoint albucino W4A16-FP8PLE de 116 Go) tient 262K de contexte à 80-89 tok/s. C'est fiable et validé, mais environ 2 fois plus lent, avec un démarrage vers 550 s et --disable-custom-all-reduce faute de P2P. Un enseignement valable même si tu restes ailleurs : sur un autre rig, sans P2P, le pipeline parallel bat le tensor parallel (117/163 tok/s contre 45/63).
llama.cpp. Support fusionné en amont le 27/08 (b10675), GGUF chez Unsloth et ISTA. Sur un profil proche du mien (PCIe 3.0, DDR4), les séries publiées montent de 17 à 37-41 tok/s avec UD-Q4_K_XL, un cache d'experts de 150 slots et MTP-3, et jusqu'à 49 en code. Sortir le cache d'experts du GPU pendant le préfill multiplie celui-ci par 2,2 à 2,5. C'est 3 à 4 fois plus lent que QEngine ou Strata, mais souvent le seul choix sur une machine à un seul GPU.
Les pièges rencontrés
Pas de P2P : le vrai plafond. Le journal de QEngine l'écrit : no peer access: collectives through pinned host memory. QEngine gère ce cas depuis la 1.3.4 (perte annoncée d'environ 4 % en décodage), mais l'écart entre rigs avec et sans P2P reste de l'ordre de 12 à 18 %. Les pistes sont dans le BIOS : Above-4G Decoding, ReBAR, ACS et IOMMU. Vérifie avec nvidia-smi topo -m.
Le placement mémoire. Sur mon EPYC à 4 nœuds NUMA, la mémoire épinglée se répartissait au hasard, avec 51 % sur des nœuds sans carte. L'entrelacer sur les 4 nœuds a donné +17 % de préfill et des démarrages enfin reproductibles. Tout est détaillé dans l'article suivant.
L'installeur de Strata force --ple-io ram. Dès que la RAM atteint modèle + table + 16 Go, l'installeur ajoute lui-même ce drapeau sur un SSD, et STRATA_PLE_AUTO_RAM=0 ne l'empêche pas. La correction : poser user_args: ["--ple-io","direct"] dans le fichier JSON de lancement du pack. Il l'emporte sur args et survit aux redémarrages. Effet mesuré : RAM utilisée de 99 à 72 Go, RAM disponible de 29 à 57 Go. À refaire après tout changement de CONTEXT ou de KV, qui relance l'installeur.
Le très long contexte. Côté Strata, la contrainte est entrée + max_tokens ≤ max-context : au-delà, c'est un HTTP 400, sans troncature. Côté QEngine, plafonne le contexte servi à ~200K, ou pose FLASH_EC_MARGIN_MB=1024 si le graph instantiate out of memory apparaît (la marge coûte environ 10 % de décodage, donc je préfère le plafond).
Laisse chauffer. Au démarrage, le cache d'experts part de 20-30 % de réussite et monte à 63 % après environ 700 pas de décodage. Le banc fait donc 3 chauffes avant les mesures : sur Strata, le premier run de code sort à 81 tok/s, puis les chauffes le montent à 111-116.
Mes réglages QEngine
À recopier tels quels si tu pars du preset :
FLASH_MAX_SEQS=8
ENABLE_THINKING=true
REASONING_EFFORT=low
VISION=1
KV_OFFLOAD_DISK=0
KV_OFFLOAD_DISK=0 est le bon choix tant que la table n-gram est épinglée en RAM. Je garde aussi le dashboard et les métriques en loopback seul : il n'a pas d'authentification et expose un POST /api/reset.
Sources et méthode
Tout ce qui est « mesuré » vient de mon banc : bench.sh pour les débits et le préfill (3 chauffes puis 5 mesures), verify-full.sh et verify-stress.sh pour les tests fonctionnels et l'échelle de contexte, avec les mêmes scripts sur les deux moteurs. Strata était en 0.2.12 (la 0.2.13 est sortie au même moment).
Les chiffres « publiés » viennent du BENCHMARKS.md du dépôt de presets QEngine, de la recette de DominikBucko pour vLLM, de la PR llama.cpp #27742 et des séries de bancs publiées autour de llama.cpp, ainsi que de discussions r/LocalLLaMA, V2EX, Juejin et CSDN. Un débit sans quantification ni longueur de contexte ne vaut rien : compare toujours à poids et contexte égaux.
and download the source files
❤️ Like this comparison? Leave a star to support fabz !
